1.คำถามเรื่อง AI ถูกตั้งขึ้นแล้ว แต่โครงสร้างที่จะรองรับคำตอบยังไม่เกิดขึ้น
ปี 2026 UNESCO และ ICOM เปิดสำรวจการใช้ปัญญาประดิษฐ์ในพิพิธภัณฑ์ทั่วโลก จุดสำคัญไม่ใช่เพียงตัวเลขที่จะประกาศในรายงาน แต่คือวิธีตั้งคำถาม องค์กรหลักของวงการไม่ได้ถามว่า "พิพิธภัณฑ์ควรใช้ AI หรือไม่" อีกต่อไป หากถามว่า "พิพิธภัณฑ์ต้องมีอะไร จึงจะใช้ AI ได้อย่างรับผิดชอบ"
งานสำรวจร่วมสมัยให้ภาพที่น่ากังวล พิพิธภัณฑ์ประมาณ 52% ใช้ AI ในรูปแบบใดรูปแบบหนึ่งแล้ว อีก 11% ไม่ทราบด้วยซ้ำว่าบุคลากรของตนกำลังใช้อยู่หรือไม่ ขณะที่มีเพียง 9% ที่มีธรรมนูญหรือแนวปฏิบัติอย่างเป็นทางการ เทคโนโลยีจึงเดินหน้าเร็วกว่าธรรมาภิบาลอย่างชัดเจน
ในอีกด้านหนึ่ง American Alliance of Museums พบว่า ประชาชนทั่วไปมากกว่า 70% ไม่ต้องการให้พิพิธภัณฑ์ใช้ AI ในการพัฒนานิทรรศการ และ 43% ไม่เห็นด้วยแม้แต่การนำไปเขียนอีเมลหรือข้อความบนเว็บไซต์
เป็นข้อมูลที่น่าสนใจ เราตีความว่าประชาชนยังให้ความเชื่อมั่นในสถาบันอย่างพิพิธภัณฑ์ และไม่ต้องการให้เข้าไปยุ่งเกี่ยวกับสิ่งที่ยังไม่มีความชัดเจนเรื่องความน่าเชื่อถืออย่าง AI
เมื่อนำข้อมูลทั้งสามด้านมาวางร่วมกัน ปัญหาจึงไม่ใช่การเลือกระหว่าง "ใช้" หรือ "ไม่ใช้" AI แต่คือการรักษาความไว้วางใจ ขณะที่เทคโนโลยีกำลังเข้าไปอยู่ในกระบวนการสร้างความรู้ของสถาบัน
ทางออกไม่ใช่เพียงใช้ AI ให้น้อยลง แต่ต้องทำให้สถาบันแสดงได้ว่า ทุกคำตอบของ AI ตั้งอยู่บนหลักฐานที่มีความน่าเชื่อถือแค่ไหน
2.ปัญหานี้มีชื่อเรียกอย่างเป็นทางการแล้ว
เดือนกุมภาพันธ์ 2026 หอสมุดรัฐสภาสหรัฐฯ เผยแพร่รายงาน Content Authenticity and Provenance in the Age of Artificial Intelligence ใจความสำคัญคือ แนวปฏิบัติด้านที่มาและความรับผิดชอบซึ่งห้องสมุดและพิพิธภัณฑ์สร้างสมมา ต้องขยายเข้าไปครอบคลุมกระบวนการที่มีเครื่องจักรเข้ามาร่วมสร้างเนื้อหา
Provenance ไม่ใช่แนวคิดใหม่ที่เกิดขึ้นเพราะ AI ห้องสมุดและพิพิธภัณฑ์ใช้หลักการนี้มาเนิ่นนาน ข้อมูลหนึ่งรายการบอกได้ว่าใครสร้าง ใครแก้ไข และแก้ไขเมื่อใด ทะเบียนวัตถุบอกได้ว่าวัตถุชิ้นนั้นผ่านมือใครมา เมื่อมีคนถามว่า "เรารู้ได้อย่างไร" ผู้รับผิดชอบสามารถพาย้อนกลับไปยังหลักฐานได้
ระบบทั้งหมดตั้งอยู่บนสมมติฐานสำคัญว่า มีผู้รับผิดชอบในทุกขั้นตอน แต่เมื่อ AI ค่อยๆ เข้ามาอยู่ในงานแต่ละส่วน สมมติฐานนี้ก็เริ่มไม่แน่นอน
- การเขียนคำบรรยาย - แชตบอตของ Nasher Museum of Art เขียนข้อความได้ลื่นไหล แต่เรียกผลงานบนกระดาษว่าเป็นประติมากรรม
- การเพิ่มข้อมูล - หอจดหมายเหตุแห่งชาติสหรัฐฯ ใช้ AI ดึงชื่อบุคคลจากสำมะโนประชากร ชื่อที่อ่านผิดกลับค้นหาได้ง่ายเท่ากับชื่อที่อ่านถูก
- การค้นพบข้อมูล - งานทดลองสร้าง metadata ของเว็บอาร์ไคฟ์ด้วย GPT-4o พบผลลัพธ์ที่ใช้ได้บางส่วน แต่ไม่สม่ำเสมอพอจะเผยแพร่โดยไม่ผ่านมนุษย์
- การลงรายการผลงานที่สร้างด้วย AI - หอสมุดรัฐสภาสหรัฐฯ ต้องจัดทำแนวทางเฉพาะสำหรับทรัพยากรประเภทนี้
สิ่งที่เหมือนกันคือ ข้อมูลใหม่ดูไม่ต่างจากข้อมูลเดิม ช่อง "หน่วยงานผู้รับผิดชอบ" ยังระบุชื่อสถาบันของคุณ แต่สิ่งที่ชื่อของสถาบันเคยรับประกันไว้ อาจไม่ได้ถูกตรวจสอบแบบเดิมอีกต่อไป
มาตรฐานอย่าง C2PA ช่วยบอกได้ว่าเกิดอะไรขึ้นกับไฟล์หนึ่งไฟล์ แต่ไม่ได้อธิบายโดยอัตโนมัติว่าข้อความแต่ละประโยคในข้อมูล อาศัยหลักฐานชิ้นใด เครื่องมือก็ดีได้เท่ากับวัสดุและการควบคุมที่อยู่รอบเครื่องมือนั้น ส่วนคำว่า "ผู้ตรวจอีกคู่หนึ่ง" ในที่นี้ หมายถึงแหล่งข้อมูล ผู้ทบทวน หรือผู้มีอำนาจอีกฝ่ายที่สามารถตรวจสอบข้ออ้างได้อย่างเป็นอิสระ
คณะทำงานของ OCLC ระบุความล้มเหลวที่เกิดซ้ำสามแบบ ได้แก่ ข้อมูลเท็จที่ไหลเข้าสู่ระบบ ผลลัพธ์ที่เปลี่ยนไปแม้ใช้ข้อมูลนำเข้าเหมือนเดิม และคะแนนความมั่นใจที่ไม่ได้สะท้อนคุณภาพจริง
เราไม่ควรตั้งสมมติฐานว่า ปัญหาเหล่านี้จะหายไปเองเพียงเพราะเอไอโมเดลรุ่นใหม่จะเก่งขึ้น สิ่งที่ต้องสร้างคือฐานความรู้ที่ตรวจสอบ โต้แย้ง และแก้ไขได้
3.เมื่อความผิดพลาดเขียนได้อย่างน่าเชื่อถือ
การทดลองของ Nasher แสดงให้เห็นว่า AI สามารถเปลี่ยนชื่อหรือจัดประเภทวัตถุผิดโดยไม่ส่งสัญญาณเตือน ส่วนการทดลองที่ Mariners' Museum พบว่าโมเดลสามแบบล้วนทำข้อผิดพลาดเฉพาะทาง แต่เริ่มมีประโยชน์จริงเมื่อภัณฑารักษ์กำกับและตรวจสอบ
ข้อมูลที่ผิดกับข้อมูลที่ถูกอาจมีหน้าตาเหมือนกันทุกประการ ผู้ชม นักวิจัย และเสิร์ชเอนจิน ไม่อาจตัดสินจากภาษาที่ลื่นไหลเพียงอย่างเดียว
4.สิ่งที่ Yale ลงทุนเรียนรู้มาแล้ว
ระหว่างปี 2018-2023 มหาวิทยาลัย Yale พัฒนา LUX ระบบค้นพบข้อมูลข้ามคอลเลกชัน ครอบคลุมข้อมูลมากกว่า 41 ล้านรายการจากสี่หน่วยงาน เชื่อมโยงกับแหล่งข้อมูลภายนอก และใช้มาตรฐาน Linked Open Usable Data, Linked Art และ IIIF
LUX เป็นหลักฐานสำคัญว่า Knowledge Graph สำหรับมรดกวัฒนธรรมข้ามสาขาสามารถสร้างได้จริง ขณะเดียวกันก็เป็นคำเตือน Oxford e-Research Centre สรุปบทเรียนหนึ่งไว้ว่าเป็นความตึงเครียดระหว่าง "ความสมบูรณ์ของแบบจำลอง" กับ "การนำข้อมูลไปใช้ได้จริง"
แบบจำลองที่สมบูรณ์ในทางทฤษฎี แต่ไม่ตอบว่าสถาบันมีอยู่เพื่ออะไร อาจกลายเป็นการลงทุนหลายปีเพื่อได้แผนภาพที่ไม่มีใครใช้
Ontology จึงต้องเริ่มจากพันธกิจ ไม่ใช่เริ่มจากมาตรฐาน
คำถามว่า "สถาบันนี้มีอยู่เพื่ออะไร และมีเรื่องใดที่สถาบันต้องสามารถกล่าวได้อย่างมีอำนาจรับรอง" เป็นคำถามที่ผู้อำนวยการ ภัณฑารักษ์ บรรณารักษ์ และผู้ดูแลคอลเลกชันต้องตอบร่วมกัน ผู้ขายระบบตอบแทนไม่ได้ และโมเดลก็อนุมานจากข้อมูลเพียงลำพังไม่ได้
งานของ Erin Canning เรื่องคำศัพท์ในการทำ critical cataloguing ย้ำว่า โครงสร้างความรู้ไม่เคยเป็นกลาง การเลือกว่าจะใช้คำใดกับประวัติศาสตร์อาณานิคม คำล้าสมัย หรือชื่อที่ชุมชนต้นทางยอมรับ คือการใช้อำนาจตีความ การมอบการตัดสินใจนี้ให้โมเดลทางสถิติ จึงไม่ใช่แค่เรื่องเทคนิค แต่คือการมอบอำนาจของสถาบันออกไป
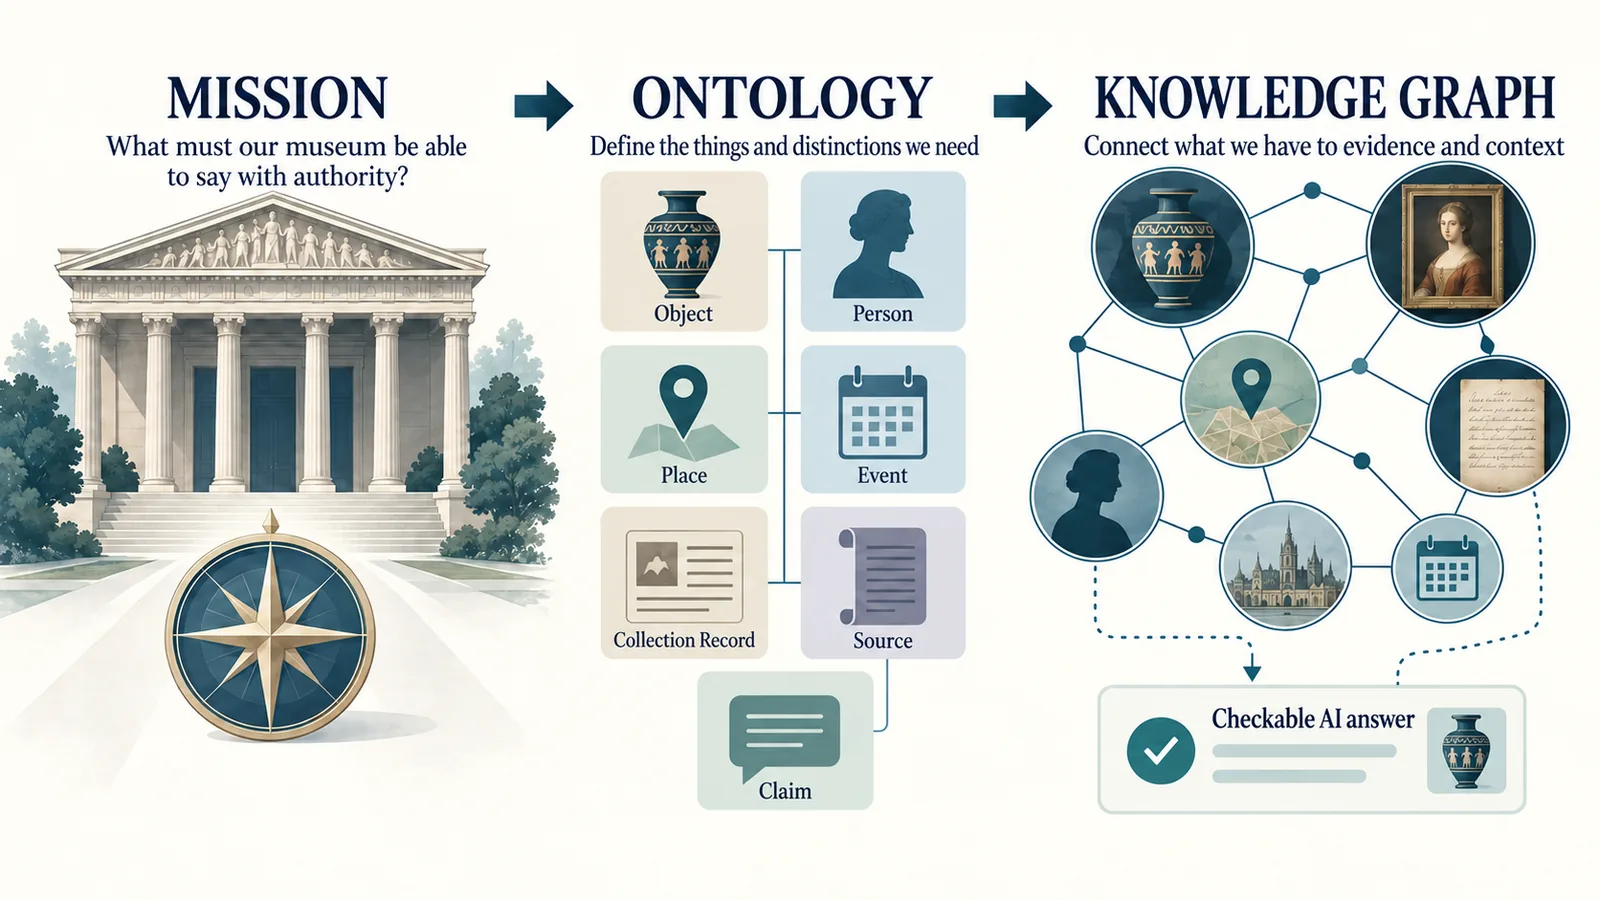
พันธกิจ กำหนดคำถามและความรับผิดชอบ Ontology กำหนดความแตกต่างที่องค์กรจำเป็นต้องมองเห็น Knowledge Graph เชื่อมสิ่งที่พิพิธภัณฑ์มีอยู่แล้ว ส่วน หลักฐานและ Provenance ทำให้ทุกเส้นทางตรวจสอบได้ AI จึงตอบจากชั้นความรู้ที่องค์กรกำกับ
AI ของพิพิธภัณฑ์ควรสืบทอดวินัยทางความรู้ของพิพิธภัณฑ์ ทั้งการลงรายการ ที่มา การควบคุมชื่อ การวินิจฉัยของภัณฑารักษ์ หลักฐาน และการอ้างอิง
5.สิ่งที่ Neo Gens เสนอ
เราร่วมออกแบบและสร้าง Ontology ที่เริ่มจากพันธกิจ และ Knowledge Graph บนคอลเลกชันที่องค์กรมีอยู่แล้ว ไม่ได้เข้ามาแทนระบบบริหารจัดการคอลเลกชัน แต่เพิ่มชั้นความรู้ที่ทำให้องค์กรนำ AI มาใช้งานได้อย่างรับผิดชอบและอธิบายได้
หลักการทั้งห้าข้อต่อไปนี้ไม่ใช่รายการแยกกัน แต่เป็นกลไกที่ต้องทำงานร่วมกัน
- ทุกข้อความเริ่มต้นในฐานะ "ข้ออ้าง" จนกว่าจะมีพยานหลักฐานรองรับข้ออ้างแต่ละรายการบันทึกว่าใครเป็นผู้กล่าว อาศัยหลักฐานใด เกิดขึ้นเมื่อใด มีสถานะอย่างไร และได้รับการยืนยันจากแหล่งอิสระเพียงใด C2PA ดูแล Provenance ระดับไฟล์ ส่วนชั้นที่ Neo Gens เพิ่มเข้ามาดูแลในระดับข้อความ
- อัตลักษณ์ต้องผ่านการตัดสิน ไม่ปล่อยให้คลุมเครือการควบคุมชื่อใช้รหัสถาวรและหน่วยงานผู้ออกที่รับผิดชอบ อาจเทียบกับ VIAF, Wikidata หรือ ORCID ชื่อที่ไม่ตรงช่วยปฏิเสธการจับคู่ได้ แต่ชื่อที่ตรงกันอย่างเดียวไม่พอจะยืนยันว่าเป็นบุคคลหรือสิ่งเดียวกัน
- ความสอดคล้องภายในไม่เท่ากับความจริงข้อมูลที่ผ่าน validation อาจยังผิด ลำดับหลักฐานจึงเริ่มจากสิ่งที่สถาบันถือครองและสังเกตโดยตรง ตามด้วยการยืนยันอิสระ ส่วนความสอดคล้องใช้เป็นเพียงตัวกรอง และผลจาก AI เข้าสู่ระบบได้ในฐานะข้ออ้างเท่านั้น
- ระบบต้องส่งเสียงเมื่อทำงานไม่สำเร็จหากการค้นหาไม่เกิดขึ้น ข้อมูลไม่ถูกบันทึก หรือคำตอบไม่มีหลักฐานรองรับ ระบบต้องแสดงให้เห็น ความล้มเหลวและความไม่แน่นอนต้องถูกรายงาน ไม่ถูกซ่อนหลังภาษาที่ฟังดูน่าเชื่อถือหรือคะแนนที่ไม่อธิบายความหมาย
- แผนที่ความรู้ต้องยอมรับพื้นที่ว่างของตนเองสิ่งที่คอลเลกชันไม่มี วัตถุที่ยังไม่ digitise คำบรรยายที่ยังเป็นข้อพิพาท และขอบเขตที่ข้อมูลไม่ครบ ต้องเป็น metadata ชั้นแรก การระบุช่องว่างอย่างแม่นยำช่วยป้องกันไม่ให้ "การไม่พบข้อมูล" ถูกตีความผิดว่า "ไม่มีอยู่จริง"
หลักการข้อใดข้อหนึ่งไม่เพียงพอในตัวเอง Provenance ที่ผูกกับตัวตนผิดย่อมพาย้อนกลับไปผิดที่ อัตลักษณ์ที่ไม่บอกช่องว่างทำให้เกิดภาพลวงว่าข้อมูลสมบูรณ์ และระบบที่แจ้งข้อผิดพลาดแต่ไม่มีหลักฐาน ก็ยังไม่ช่วยให้แก้ปัญหาได้
6.Claim-level Provenance ทำให้ "ตรวจสอบได้" อย่างไร
C2PA และ Content Credentials ช่วยพาข้อมูลที่มาของสินทรัพย์ดิจิทัลไปกับไฟล์ ส่วนชั้นความรู้ของ Neo Gens เข้ามาเติมสิ่งที่สถาบันใช้ในการตอบคำถามจริง นั่นคือ Provenance ในระดับข้ออ้าง
| คำตอบจาก AI | "วัตถุ X สร้างขึ้นที่กรุงเทพฯ ในปี 1957" |
|---|---|
| ข้ออ้าง 1 | วัตถุ X · สร้างที่ · กรุงเทพฯ |
| ข้ออ้าง 2 | วัตถุ X · ปีที่สร้าง · 1957 |
| หลักฐาน | ข้อมูลคอลเลกชัน · บันทึกภัณฑารักษ์ · เอกสารจดหมายเหตุ |
| ความรับผิดชอบ | แหล่งที่มา · ผู้รับผิดชอบ · วันที่ · สถานะ · ประวัติการทบทวน |
ทำไมต้องเป็นกราฟ และทำไมต้องเริ่มตอนนี้
ฐานข้อมูลดึงข้อมูลขึ้นมาได้ ส่วนกราฟแสดงได้ด้วยว่าข้อมูลนั้นเชื่อมกับบุคคล สถานที่ เหตุการณ์ แหล่งข้อมูล และข้ออ้างอย่างไร รวมถึงเส้นทางหลักฐานใดที่รองรับคำตอบ สถาบันจึงตรวจสอบและแก้ไขเหตุผลเบื้องหลังคำตอบได้ โดยไม่ต้องบีบความรู้ทั้งหมดให้เหลือตารางเดียวหรือเรื่องเล่าแบบเดียว
MuseKG แสดงรูปแบบการทำงานนี้อย่างเป็นรูปธรรม ด้วย typed property graph ที่ให้ Provenance เป็นความสัมพันธ์หลัก เชื่อมคำถามภาษาธรรมชาติเข้ากับ entity ในกราฟ และดึงเฉพาะกลุ่มหลักฐานที่เกี่ยวข้องขึ้นมาประกอบคำตอบ
ศัพท์กลางของวงการพร้อมพอให้เริ่มทำงานได้แล้ว CIDOC CRM (ISO 21127:2023) รองรับ semantic interoperability ส่วน Linked Art ทำให้การประยุกต์ใช้กับคอลเลกชันศิลปะเป็นไปได้จริง แนวทางของเราคือใช้มาตรฐานในส่วนที่ตอบโจทย์ ขยายเฉพาะเมื่อพันธกิจต้องการความแตกต่างเพิ่มเติม และบันทึกเหตุผลของทุกส่วนที่ขยาย
7.ก้าวต่อไปคือ Pilot Project ที่มีขอบเขตชัดเจน
Pilot แรกควรเล็กพอให้ทุกฝ่ายตรวจดูได้จริง และสำคัญพอที่จะทำให้สถาบันเรียนรู้ เริ่มจากคอลเลกชันบางส่วน พร้อมชุดคำถามที่องค์กรจำเป็นต้องตอบอย่างมีอำนาจรับรอง
- เลือกขอบเขตคอลเลกชัน
- Mission Workshop
- กำหนดคำถามสำคัญ
- ทำ Ontology Mapping
- กระทบยอดอัตลักษณ์
- ออกแบบ Provenance
- สร้างกราฟที่ใช้งานได้
- ทดลองถามตอบด้วย AI
- ประเมินร่วมกับภัณฑารักษ์
ผลลัพธ์ของ Pilot Project ประกอบด้วยแบบจำลองพันธกิจ ชุดคำถามที่ตกลงร่วมกัน แผนผัง entity-ข้ออ้าง-ความสัมพันธ์ นโยบายอัตลักษณ์และ Provenance กราฟที่ใช้งานได้ ต้นแบบการถามตอบ และบันทึกการประเมินว่าแนวทางนี้สำเร็จ ล้มเหลว หรือควรปรับตรงไหน
การตัดสินใจเมื่อจบ Pilot Project จะตั้งอยู่บนหลักฐาน ว่าควรหยุด ปรับ หรือขยาย ไม่มีสถาบันใดควรผูกพันกับโครงการหลายปี ก่อนเห็นว่าวิธีการทำงานได้กับข้อมูลและบุคลากรของตนจริง
8.สิ่งที่ข้อเสนอนี้ไม่ได้กล่าวอ้าง
- นี่ไม่ใช่โครงการ digitisation และไม่ใช่บริการทำความสะอาด metadata ข้อมูลที่บางและความขัดแย้งที่ยังไม่คลี่คลายจะเห็นชัดขึ้น ไม่ใช่ถูกปิดบัง
- โครงสร้างนี้ไม่ได้ทำให้ AI ถูกต้องเสมอ แต่ทำให้ AI ตรวจสอบได้ คุณค่าคือคำตอบสามารถถูกสืบย้อน โต้แย้ง แก้ไข และพัฒนาต่อได้
- Knowledge Graph ไม่ได้แทนที่อำนาจของภัณฑารักษ์หรือบรรณารักษ์ แต่ให้โครงสร้างที่ทำให้หลักฐาน การตัดสินใจ ความไม่แน่นอน และข้อจำกัด เดินทางไปพร้อมกับคำตอบ
- มาตรฐานคือฐานร่วม ไม่ใช่สิ่งทดแทนพันธกิจ เราใช้ศัพท์กลางเพื่อเชื่อมโยงกับโลกภายนอก พร้อมรักษาความแตกต่างที่สถาบันของคุณมีหน้าที่ต้องมองเห็น
สรุปในสามประโยค
- องค์กรหลักของวงการ ทั้ง UNESCO, ICOM, Library of Congress และ OCLC ต่างชี้ไปยังปัญหาเดียวกัน AI กำลังเข้าสู่กระบวนการจัดการคอลเลกชันเร็วกว่าที่แนวปฏิบัติด้าน Provenance ซึ่งเคยค้ำประกันความน่าเชื่อถือจะปรับตัวทัน
- คำตอบคือชั้นความรู้ที่บันทึกว่าเรารู้อะไร รู้ได้อย่างไร และยังไม่รู้อะไร เพื่อให้คำตอบจาก AI ทุกชิ้นย้อนกลับไปยังหลักฐานของสถาบันได้ หรือถูกแสดงอย่างชัดเจนว่ายังเป็นเพียงข้ออ้าง
- Neo Gens ออกแบบและสร้างชั้นความรู้นี้ร่วมกับทีมของคุณ เริ่มจาก Pilot ที่มีขอบเขตชัด และแบบจำลองที่ตอบพันธกิจว่าเรื่องใดคือสิ่งที่สถาบันต้องสามารถกล่าวได้อย่างมีอำนาจรับรอง
AI สร้างภาษาได้ แต่สถาปัตยกรรมความรู้ทำให้ฐานะของคำพูดนั้นมองเห็นและตรวจสอบได้
Noppadol Weerakitti · noppadol@neogens.co · neogens.co
เอกสารอ้างอิง
- Murray, K. & Sternfeld, J., Content Authenticity and Provenance in the Age of Artificial Intelligence, Library of Congress / C2PA for G+LAM, 2026.
- UNESCO & ICOM, Global Survey on the Use of Artificial Intelligence in Museums, 2026; American Alliance of Museums, AI in Museums and Community Trust, 2026.
- OCLC Research Library Partnership, Managing AI in Metadata Workflows Working Group; Library of Congress, Cataloging of Resources Generated Using AI Software - FAQ.
- American Alliance of Museums, Curatorial Chatbot: An Experiment with AI at the Nasher Museum of Art; US National Archives, AI-assisted name extraction.
- Yale University, LUX cross-collection discovery platform; Oxford e-Research Centre, Semantic Completeness vs Data Usability.
- Canning, E., Defining an Ontology for Museum Critical Cataloguing Terminology Guidelines.
- MuseKG: An Interactive Knowledge Graph Over Museum Collections, SIGIR '26; CIDOC CRM, ISO 21127:2023; Linked Art profile.
- From Fluent to Verifiable: Claim-Level Auditability for Deep Research Agents, arXiv, 2026; Web Archives Metadata Generation with GPT-4o, arXiv.